На входе:
- живой продукт вокруг TTS;
- сильный брендовый UI (тёмно-синяя палитра, типографика, анимации);
- запрос на Video Generation: Text-to-Video и Image-to-Video;
- требование сразу думать как AI-агрегатор — с возможностью подключать новые модели и типы генерации без перестройки сайта.
Цель этапа: один кабинет, два направления (речь и видео), единая история, понятные лимиты и backend, который держит ключи провайдеров и оркестрирует асинхронную генерацию.
Что такое Syntext
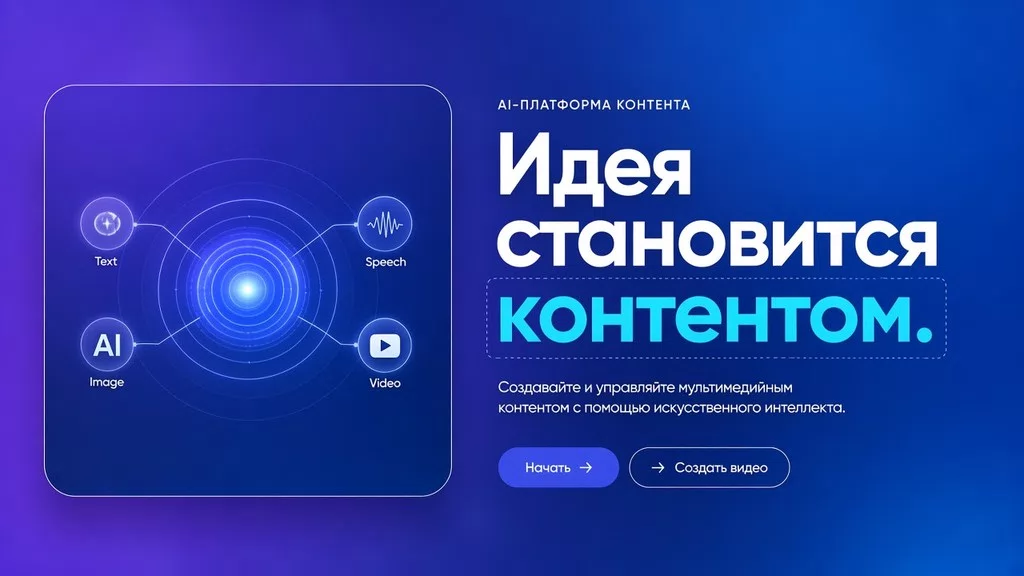
Syntext — веб-платформа для создания аудио и короткого видео с помощью AI.
В одном продукте:
- Text-to-Speech — текст → речь с выбором голоса, параметров и экспортом;
- Text-to-Video — описание → клип;
- Image-to-Video — изображение + prompt → анимация / ролик;
- единая история Audio / Video;
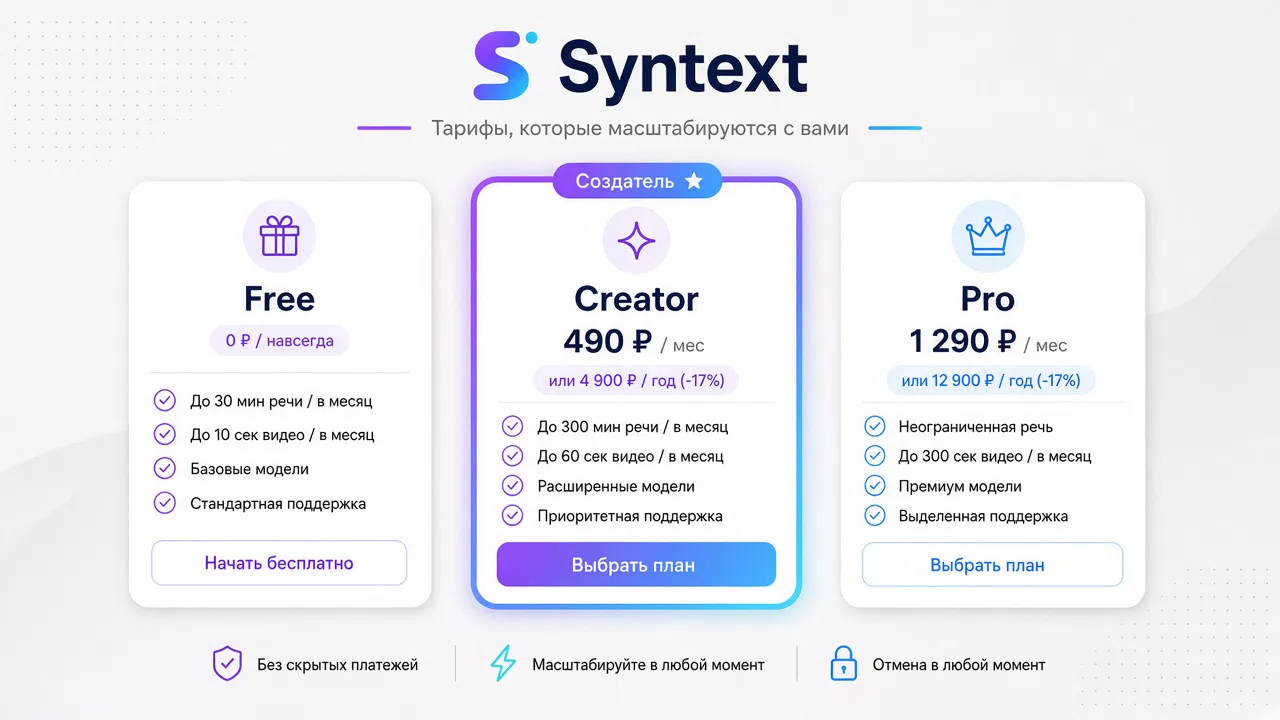
- тарифы и пакеты по минутам речи и секундам видео;
- заявка на API для программного доступа.
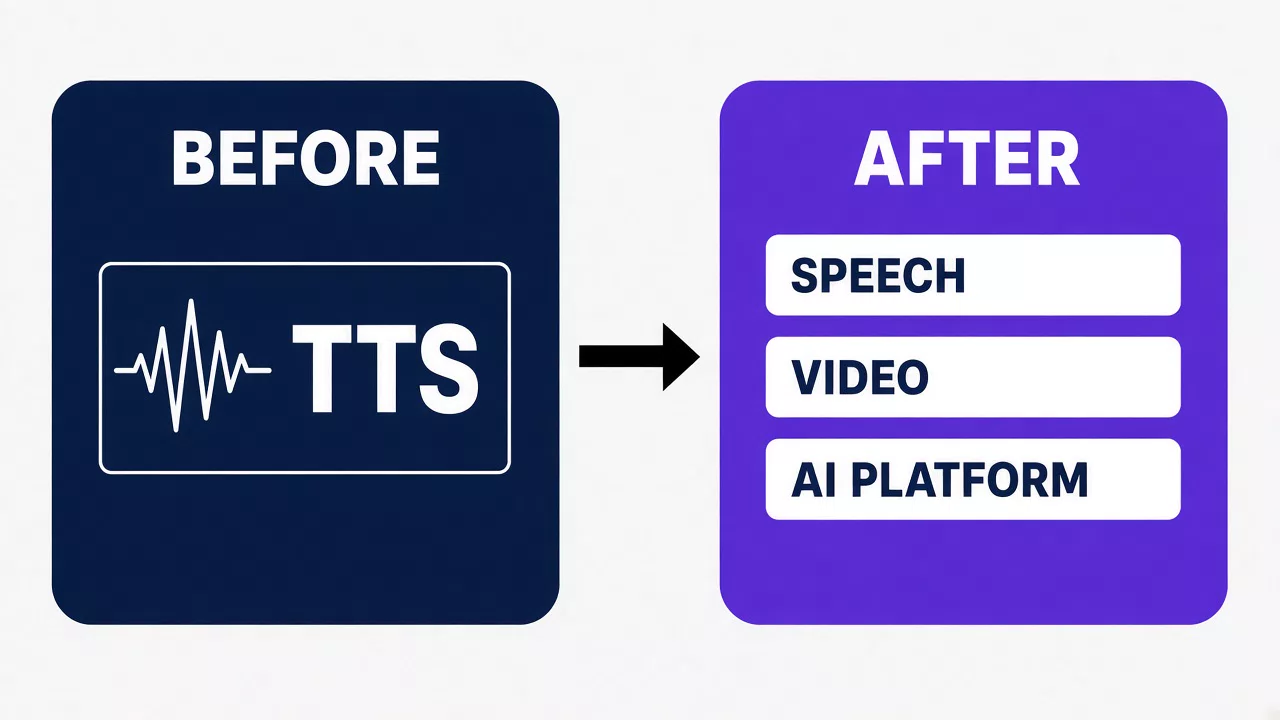
Позиционирование: не «ещё один TTS», а точка входа в генерацию контента с единым UX-потоком Input → Processing → Generation → Result.
Главные возможности
1. Text-to-Speech
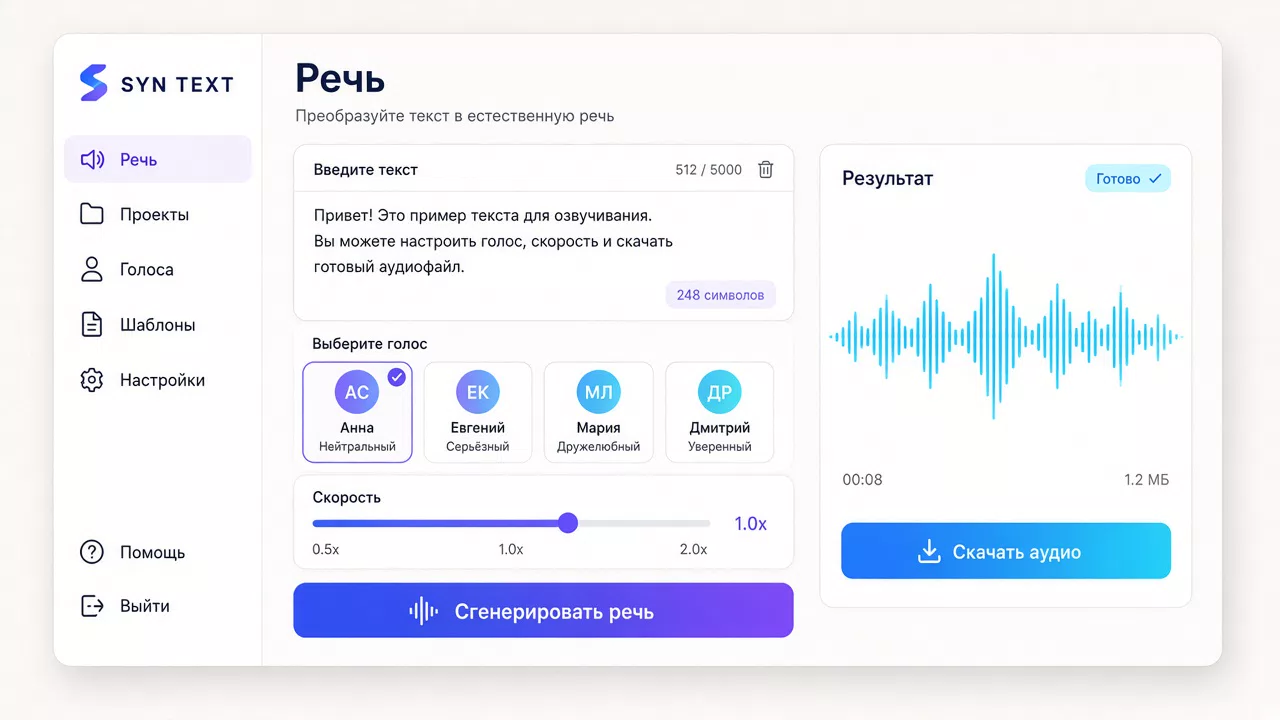
Рабочий сценарий озвучки в кабинете:
- редактор текста и предпросмотр;
- каталог голосов (русский в приоритете, также английский и немецкий);
- параметры скорости, пауз, формата;
- inline-теги управления речью (для моделей вроде Higgs TTS);
- экспорт результата (WAV / MP3);
- учёт минут по тарифу.
Публичная demo позволяет попробовать озвучку без полного захода в кабинет.
2. Video Generation
Раздел Create Video рассчитан на два режима:
- Text-to-Video — генерация по текстовому описанию;
- Image-to-Video — генерация / анимация на основе загруженного кадра.
В UI заложен каталог моделей семейства Wan (включая Wan 2.2 / 2.7 / 3.0 и связанные пресеты): длительность, разрешение, режимы описания / кадров / референсов.
Статусы генерации асинхронные: подготовка → обработка → генерация → готовый результат со скачиванием.
3. Единая история генераций
В /app/istoriya собираются результаты обоих направлений:
- тип: Audio / Video;
- режим (для видео — Text-to-Video / Image-to-Video);
- дата, prompt, статус;
- повторный просмотр и скачивание.
История спроектирована так, чтобы позже добавлять новые типы генерации без смены модели «личного кабинета».
4. Маркетинг, тарифы и сценарии
Публичная часть объясняет продукт через:
- лендинг с позиционированием AI platform;
- страницы возможностей, голосов, тарифов, FAQ;
- сценарии использования: YouTube, подкасты, аудиокниги, обучение;
- страницу API со сбором заявок.
Тарифная логика — минуты речи + секунды видео, плюс разовые пакеты поверх подписки. Коммерческий контур рассчитан на подключение оплаты и ручное/автоматическое включение доступа.
Архитектура
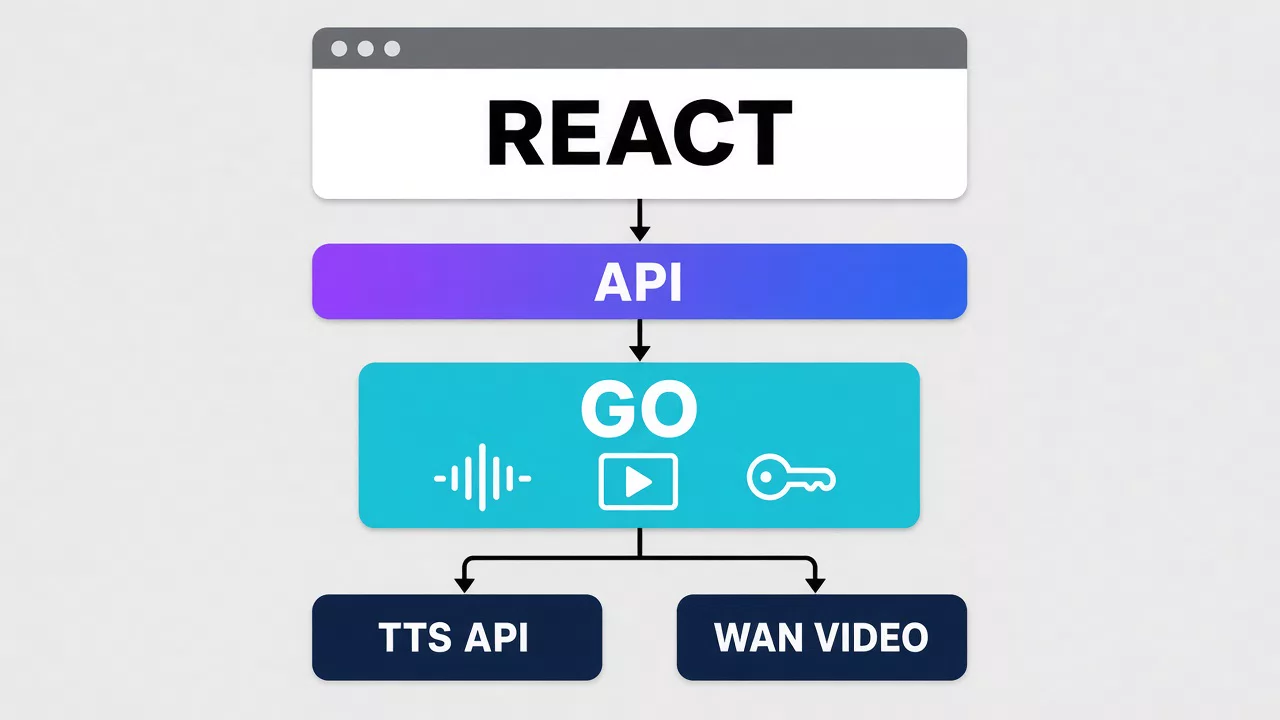
Продукт разделён на два контура с разными ролями.
React — лицо продукта
SPA без SSR:
- PublicLayout — лендинг, demo, auth, маркетинг;
- AppLayout — генератор речи, видео, история, настройки.
Стек фронта: Vite, React 19, TypeScript, Tailwind CSS 4, React Router, Zustand, Framer Motion.
Фронт отвечает за UX генерации, визуальные состояния загрузки, лимиты в интерфейсе и работу с результатом. Прямого доступа к ключам внешних AI API у клиента нет.
Go — AI-агрегатор и оркестратор
Backend на Go принимает запросы кабинета и:
- валидирует параметры генерации;
- создаёт задачу у AI-провайдера;
- хранит идентификатор и статусы задачи;
- опрашивает / принимает результат;
- отдаёт готовый файл или ссылку клиенту;
- учитывает расход лимитов пользователя.
Ключи провайдеров живут только на backend. Схема на первом этапе:
Syntext Frontend (React)
↓
Syntext Backend (Go)
↓
AI Provider / Model (TTS · Wan и др.)
↓
Generation Result
Так платформа остаётся агрегатором: можно менять TTS-модели, Video-модели и добавлять новые типы генерации, не переписывая кабинет целиком.
Почему такой раздел ролей
- UI и брендовый опыт развиваются быстро на React;
- долгие AI-задачи, ретраи, таймауты и секреты — зона backend;
- Go удобен для конкурентной оркестрации множества асинхронных job’ов;
- единый API-контракт фронта позволяет менять провайдера «под капотом».
Как обычно выглядит рабочий сценарий
Озвучка
- Открыть кабинет
/app или demo /tekst-v-rech.
- Вставить текст, выбрать голос и параметры.
- Запустить генерацию и дождаться статуса ready.
- Скачать аудио или найти версию в истории.
Видео
- Открыть
/app/video.
- Выбрать Text-to-Video или Image-to-Video.
- Задать prompt / загрузить кадр, выбрать модель и длительность.
- Дождаться асинхронной генерации и скачать клип.
Продуктовый смысл — речь и видео живут в одном ритме интерфейса: одинаковые фазы ожидания, понятный расход лимита, общая история.
Кому это полезно
Авторы YouTube / Shorts / Reels
Закадровый голос и короткие AI-клипы без отдельной студии и без прыжков между сервисами.
Подкастеры и аудиопроекты
Интро, аутро, черновые дорожки, повторная генерация после правок сценария.
Образовательные продукты
Голос к слайдам, микро-клипы к урокам, быстрые итерации текста.
Команды контента и маркетинг
Единый кабинет под регулярный выпуск роликов, тизеров и озвучек с контролем лимитов.
Разработчики / интеграции
Заявка на API — путь к программной генерации поверх того же backend-агрегатора.
Ключевые решения проекта
- расширить TTS до AI-платформы, не делая новый сайт с нуля;
- сохранить визуальный язык Syntext и адаптировать его под Audio + Video;
- держать единый UX-поток генерации для разных модальностей;
- вынести секреты и оркестрацию провайдеров в Go-backend;
- проектировать историю и кабинет как основу AI-агрегатора, а не как «два отдельных инструмента»;
- считать лимиты в понятных единицах: минуты речи и секунды видео;
- не светить API-ключи во фронте даже на этапе mock / интеграции.
Что уже есть в продуктовой оболочке
- лендинг и публичные страницы (возможности, голоса, сценарии, тарифы, FAQ, API);
- auth-экраны и кабинет с боковой навигацией;
- генератор речи и Create Video;
- единая история Audio / Video;
- каталог голосов и моделей Video;
- тарифная сетка и пакеты дозакупки;
- дизайн-токены, анимации состояний, адаптив desktop / mobile.
Дальнейший контур — усиление production-backend: реальные провайдеры, биллинг, устойчивость job’ов, расширение моделей и программный API.
Следующий шаг
Откройте syntext.cc, попробуйте demo озвучки и загляните в кабинет Video — там видно, как два направления уже живут в одной продуктовой оболочке.